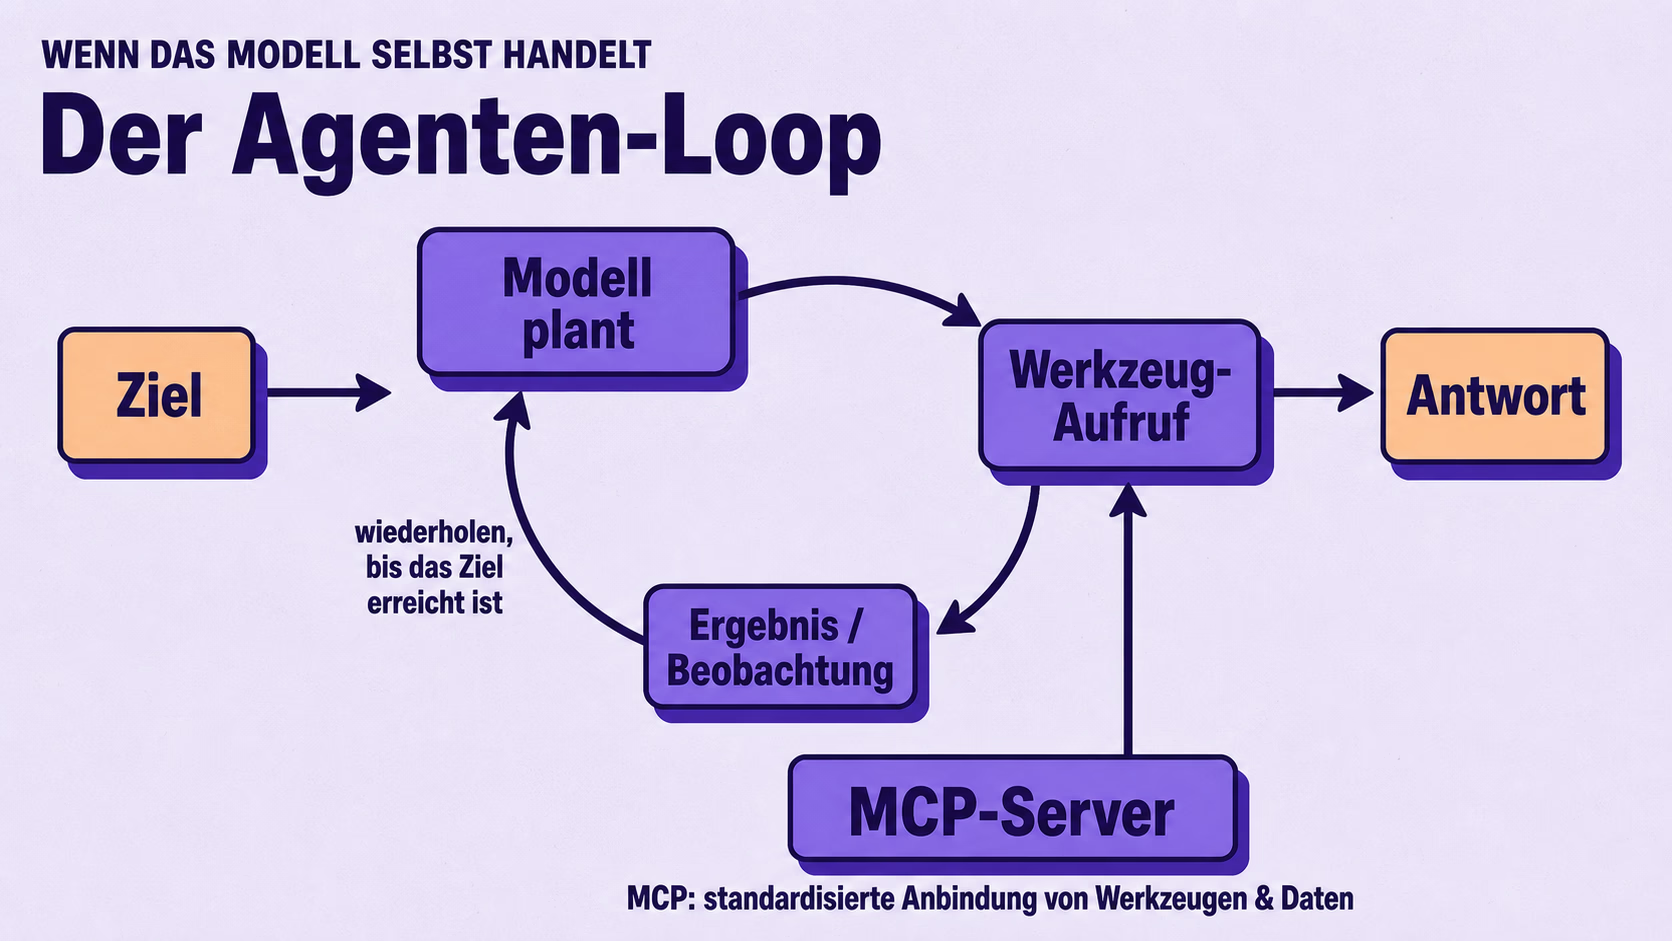
Ein KI-Agent kann während einer Aufgabe entscheiden, welche Werkzeuge und Schritte er als Nächstes braucht. Die Anwendung führt seine Aufrufe aus und liefert Rückmeldungen. Damit lassen sich offene Aufgaben bearbeiten, etwa eine Recherche oder Fehlersuche. Verlässlich wird der Ablauf erst durch passende Rechte, überprüfbare Ergebnisse und klare Abbruchbedingungen.
4 Min. Lesezeit
11 Abschnitte
20 Quellen
Stand: 16. Juni 2026
Wer entscheidet über den nächsten Schritt?
Bei einem Workflow steht die Abfolge im Programm: Dokument lesen, Felder extrahieren, Ergebnis prüfen. Bei einem Agenten entscheidet das Modell anhand der Zwischenergebnisse, wie es weitergeht. In der Praxis können beide Formen kombiniert werden.
Ein fester Ablauf ist leichter zu prüfen, wenn die Schritte bekannt sind. Ein Agent bietet Spielraum, wenn erst während der Arbeit klar wird, was noch fehlt. Diese Flexibilität kostet zusätzliche Aufrufe und erschwert die Vorhersage des Ablaufs.
Das Modell schlägt vor, die Anwendung führt aus
Beim Tool-Use erzeugt das Modell einen Aufruf mit Werkzeugname und Argumenten. Die Anwendung führt ihn aus und gibt das Ergebnis zurück. Eine Wetterabfrage benötigt beispielsweise einen Ort; das Ergebnis stammt dann vom angebundenen Dienst.
Die Werkzeugdefinition beschreibt diese Schnittstelle. Sie setzt noch keine Rechte durch. Die Anwendung muss Werte validieren, Zugriffe begrenzen und Fehler zurückmelden. Das folgende Schema ist ein vereinfachtes Beispiel, keine vollständige Sicherheitsprüfung:
{"name":"wetter_abfragen","description":"Liefert das aktuelle Wetter für einen Ort.","input_schema":{"type":"object","properties":{"ort":{"type":"string","description":"Stadt, z. B. Wien"},"einheit":{"type":"string","enum":["celsius","fahrenheit"]}},"required":["ort"]}}
Ein Ablauf mit Rückmeldungen
Angenommen, ein Agent soll einen fehlerhaften Export reparieren. Er liest den Code, stellt den Fehler nach, ändert die betroffene Stelle und führt die Prüfung erneut aus. Das Testergebnis bestimmt, ob er weiterarbeiten muss.
Der Ablauf braucht ein überprüfbares Ziel. „Fertig“ sollte hier bedeuten, dass der Fehler behoben und relevantes bestehendes Verhalten geprüft ist. Zusätzlich begrenzen Zeit, Budget und Schrittzahl, wie lange ein erfolgloser Versuch fortgesetzt wird.
Das Model Context Protocol verbindet KI-Anwendungen mit Servern, die Werkzeuge, Ressourcen oder Vorlagen bereitstellen. Ein gemeinsames Protokoll reduziert den Aufwand für individuelle Integrationen. Die Anwendung bleibt dafür zuständig, welche Fähigkeiten sie dem Modell zugänglich macht.
Nicht jeder Client unterstützt jede Funktion gleich. Prüfe daher konkrete Funktionen, Authentifizierung und Berechtigungen. Ein MCP-Server ist eine technische Schnittstelle und kein Gütesiegel für die Daten, die er liefert.
Werkzeugbeschreibungen und Ergebnisse können viel Kontext belegen. Das ist aber keine feste Eigenschaft von MCP: Anwendungen können Werkzeuge erst bei Bedarf suchen und laden. Anthropic beschreibt solche Verfahren für umfangreiche Werkzeugsammlungen.
Ein Kommandozeilenwerkzeug kann für einen Agenten mit Shell-Zugang gut passen. Vergleiche dabei die tatsächlich geladenen Beschreibungen und ausgegebenen Daten. Ein pauschaler Prozentaufschlag pro MCP-Server sagt ohne Konfiguration und Aufgabe wenig aus.
Bei Browserautomatisierung können Seitenzustände, Screenshots und Zugänglichkeitsbäume umfangreich werden. Ein gezielter Ausschnitt oder ein gespeichertes Ergebnis mit nachladbarem Inhalt kann den Kontext entlasten.
Welche Darstellung passt, hängt vom Auftrag ab. Für eine Schaltflächenbeschriftung genügt vielleicht Text; für einen abgeschnittenen Dialog brauchst du das Bild. Ein einmaliger Vergleich von CLI und MCP belegt deshalb keinen festen Kostenvorteil für jede Browseraufgabe.
Eine Shell kann viele Aufgaben mit wenigen Werkzeugdefinitionen erledigen. Sie eröffnet zugleich einen breiten Aktionsraum. Eng definierte Werkzeuge können Rechte stärker begrenzen, benötigen aber passende Implementierung und Pflege.
Entscheide nach Umgebung und Auftrag. Für einen lesenden Zugriff auf Kundendaten ist eine begrenzte Abfrage meist leichter abzusichern als ein allgemeiner Systemzugang. Für Entwicklung in einer isolierten Arbeitsumgebung kann eine Shell zweckmäßig sein.
Das Agent2Agent-Protokoll (A2A) beschreibt die Kommunikation zwischen Agentensystemen. Über eine Agent Card werden Fähigkeiten und Schnittstellen auffindbar; Aufgaben und Ergebnisse lassen sich über gemeinsame Strukturen austauschen.
MCP und A2A adressieren unterschiedliche Verbindungen: Werkzeugzugriff und Zusammenarbeit zwischen Agenten. In einem Produkt können beide vorkommen. Eine gemeinsame Sprache garantiert allerdings nicht, dass sich die Systeme über fachliche Annahmen oder Verantwortlichkeiten einig sind.
Arbeitsschritte sinnvoll verbinden
Wiederkehrende Muster sind eine Kette von Schritten, die Weiterleitung an spezialisierte Abläufe und die parallele Bearbeitung unabhängiger Teilfragen. Ein Koordinator kann Ergebnisse zusammenführen; ein Prüfschritt kann eine Überarbeitung auslösen.
Beschreibe vor dem Bau die Übergabe: Was erhält der nächste Schritt, was muss geprüft sein und wie wird mit einem Fehler umgegangen? Dadurch wird klarer, ob du mehrere Agenten oder nur einige aufeinanderfolgende Aufrufe brauchst.
Anthropics Bericht über sein Recherche-System beschreibt einen Leitagenten mit parallelen Helfern. Im internen Test verbesserte dieser Aufbau das Ergebnis gegenüber dem verwendeten Einzelagenten, benötigte aber deutlich mehr Tokens. Das ist ein Befund zu diesem System, keine feste Gewinn- oder Kostenquote für Multi-Agenten.
Parallele Recherche kann gut passen, wenn Teilfragen unabhängig sind. Eng gekoppelte Änderungen brauchen dagegen gemeinsame Entscheidungen. Die Aufteilung lohnt sich nur, wenn ihr Nutzen den zusätzlichen Aufwand für Übergaben und Zusammenführung übersteigt.
Fremde Webseiten, Dateien und Werkzeugbeschreibungen können eingeschleuste Anweisungen enthalten. Ein Agent mit sensiblen Daten und externen Kommunikationswegen muss deshalb besonders sorgfältig begrenzt werden. Ein Filter allein garantiert nicht, dass jede solche Anweisung erkannt wird.
Vergib nur notwendige Rechte und sichere folgenreiche Aktionen separat ab. Halte Werkzeugaufrufe und Fehler nachvollziehbar fest. Eine gescheiterte Aktion darf nicht durch bloßes Wiederholen immer größere Nebenwirkungen erzeugen.
MerksatzAutonomie braucht einen begrenzten Aktionsraum und ein prüfbares Ziel.