Ein Sprachmodell erzeugt Antworten, indem es Text Stück für Stück fortsetzt. Im Training lernt es dafür sprachliche Muster und Zusammenhänge. Das reicht für Übersetzungen, Erklärungen und Code – sichert aber keine korrekten Fakten. Wer Tokens, Kontext und Training auseinanderhält, kann die Fähigkeiten und Grenzen besser einschätzen.
4 Min. Lesezeit
9 Abschnitte
9 Quellen
Stand: 16. Juni 2026
Wie aus Vorhersage eine Antwort wird
Ein großes Sprachmodell (Large Language Model, LLM) ist ein neuronales Netz. Bei der Texterzeugung berechnet es aus dem bisherigen Kontext Wahrscheinlichkeiten für das nächste TokenDie kleinste Verarbeitungseinheit eines Sprachmodells – ein Wortstück, kein ganzes Wort. Faustregel: rund 1.000 Tokens entsprechen grob 750 deutschen Wörtern. Preise und Kontextlängen werden in Tokens gerechnet.Mehr im Wissen →. Ein Auswahlverfahren bestimmt die Fortsetzung; danach beginnt der nächste Schritt. Es wird dabei nicht zwangsläufig immer das wahrscheinlichste Token gewählt.
Für eine passende Fortsetzung muss das Modell mehr als Grammatik lernen: auch Zusammenhänge, typische Argumentationen und Muster in Programmcode. Aus dem Trainingsziel allein folgt deshalb weder, dass es bloß Texte kopiert, noch, dass es wie ein Mensch versteht. Ob eine Antwort stimmt, muss sich am Inhalt zeigen.
MerksatzEine flüssige Antwort zeigt, dass das Modell den Text fortsetzen kann. Ob die Aussage stimmt, ist eine eigene Prüfung.
Warum ein Wort mehrere Tokens kosten kann
Ein Token kann ein Wort, ein Wortteil, ein Satzzeichen oder ein anderes Textstück sein. Der Tokenizer legt fest, wie die Eingabe zerlegt wird. Für englischen Fließtext kursiert die grobe Faustregel von vier Zeichen pro Token; für Code, Tabellen oder andere Sprachen kann sie deutlich danebenliegen.
Petrov und Kollegen zeigten 2023, dass Übersetzungen desselben Inhalts je nach Sprache sehr unterschiedliche Tokenmengen ergeben. Einen festen Aufschlag für Deutsch gibt es daraus nicht. Auch ein Wechsel des Tokenizers verändert die Zählung. Für eine Kostenrechnung zählt deshalb dein tatsächlicher Text im Tokenizer des gewählten Modells.
Was im Kontextfenster Platz finden muss
Das KontextfensterDie maximale Textmenge (in Tokens), die ein Modell pro Anfrage gleichzeitig „im Blick“ hat – Eingabe plus bisheriger Verlauf. Ist es voll, fällt Älteres aus dem Kontext.Mehr im Wissen → begrenzt, wie viel ein Modell in einer Anfrage verarbeiten kann. Dazu gehören Anweisungen, Gesprächsverlauf, Dokumente, Werkzeugergebnisse und die Ausgabe. Auch Medien belegen Platz; die genaue Zählung hängt vom Modell ab.
Ein voller Chat wird je nach Anwendung gekürzt, zusammengefasst oder abgewiesen. Das Modell vergisst dabei nicht selbstständig wie ein Mensch: Die Anwendung verändert, welche Inhalte es erhält. Ein großes Fenster garantiert zudem nicht, dass jede darin enthaltene Information zuverlässig genutzt wird. Die Studien „Lost in the Middle“ und „RULER“ zeigten solche Grenzen an den damals getesteten Modellen.
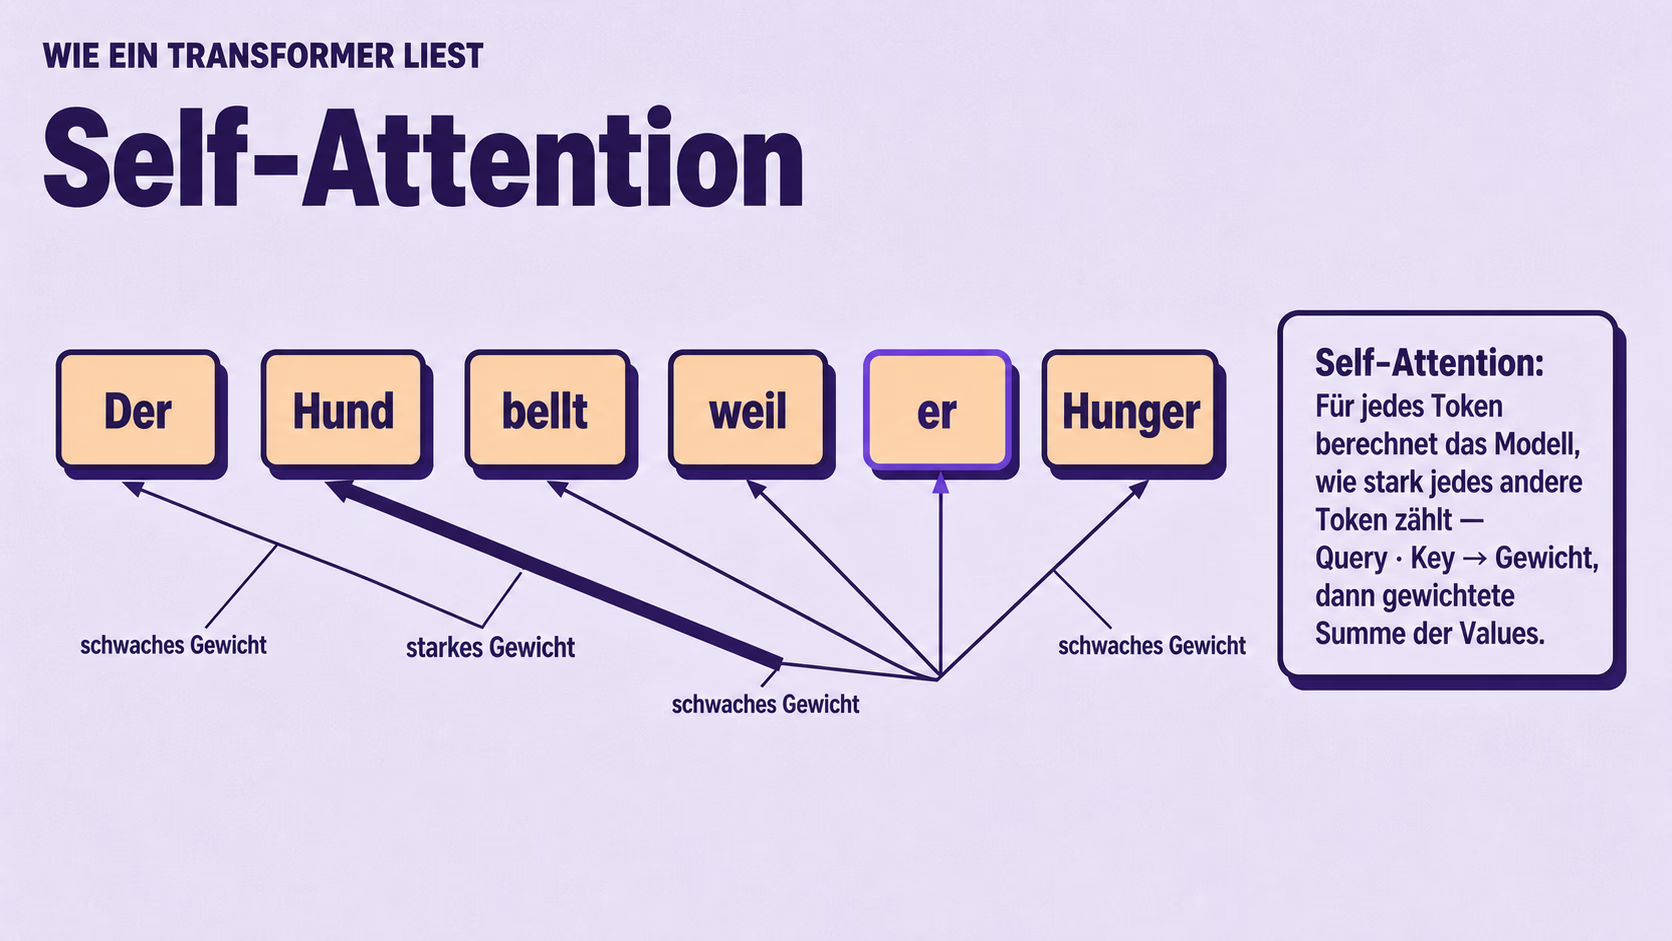
Transformer wurden 2017 mit „Attention Is All You Need“ vorgestellt. Ihr Attention-Mechanismus gewichtet Beziehungen zwischen Textpositionen. Im Satz „Der Hund bellt, weil er Hunger hat“ kann so der Bezug zwischen „er“ und „Hund“ in die Verarbeitung eingehen.
Viele Sprachmodelle nutzen diese Architektur oder Varianten davon. Beim Erzeugen einer Antwort darf ein autoregressives Modell nur auf bereits vorhandenen Kontext zugreifen. Das Training lässt sich stärker parallelisieren als die anschließende Ausgabe Token für Token.
Was Vorhersage mit Kompression zu tun hat
Eine gut vorhersehbare Nachricht lässt sich mit wenig zusätzlicher Information beschreiben. Wer etwa das nächste Wort schon sehr wahrscheinlich kennt, braucht weniger Information, um die tatsächliche Fortsetzung zu kodieren. Darin liegt der Zusammenhang zwischen Sprachvorhersage und Datenkompression.
Das ist eine hilfreiche Erklärung dafür, warum Mustererkennung nützt. Eine allgemeine Definition von Intelligenz ergibt sich daraus nicht. Die populäre Formel „Kompression ist Intelligenz“ geht weiter als der mathematische Zusammenhang.
Was die Parameterzahl verrät
Parameter sind die im Training angepassten Zahlen des Netzes. Sie bestimmen zusammen, wie Eingaben verarbeitet werden. Eine größere Parameterzahl bedeutet mehr gespeicherte Gewichte; sie sagt noch nicht, wie gut ein Modell eine bestimmte Aufgabe löst.
Daten, Architektur und Training beeinflussen das Ergebnis ebenso. Ein historischer Größenanker ist GPT-3 mit 175 Milliarden Parametern aus dem Jahr 2020. Als alleinige Kaufentscheidung taugt eine solche Zahl nicht.
Warum bei MoE zwei Größenangaben stehen
Bei MoE (Mixture of Experts)Architektur, bei der je Anfrage nur ein Teil des Modells („Experten“) aktiv wird. So hat das Modell sehr viele Gesamt-Parameter, rechnet aber nur mit wenigen aktiven – das spart Rechenzeit.Mehr im Wissen → (MoE) wird pro Token nur ein Teil der sogenannten Experten aktiviert. Deshalb unterscheiden Modellkarten zwischen gesamten und aktiven Parametern. Die erste Zahl beschreibt den Umfang der Gewichte, die zweite die pro Token beteiligten Gewichte.
Weniger aktive Parameter können Rechenaufwand sparen. Die übrigen Gewichte müssen im Betrieb trotzdem verfügbar sein. Ein MoE-Modell mit wenigen aktiven Parametern passt daher nicht automatisch auf einen kleinen Rechner.
MerksatzFür MoE getrennt prüfen: Wie viel Speicher brauchen alle Gewichte, und wie viel wird pro Token berechnet?
Neben der Modellgröße gibt es mehrere Ansatzpunkte für Effizienz: QuantisierungVerfahren, das die Gewichte eines Modells mit weniger Bits speichert (z. B. 4 statt 16). Das senkt Speicher- und Hardwarebedarf deutlich, kostet aber etwas Genauigkeit – wichtig fürs lokale Betreiben.Mehr im Wissen → reduziert die Zahlpräzision, sparsame Attention-Verfahren verkleinern den Aufwand für lange Kontexte, und verbesserte Trainingsverfahren nutzen Rechenzeit anders.
Eine Einsparung gilt immer für den gemessenen Aufbau. Ein kleinerer Zwischenspeicher bedeutet beispielsweise nicht dieselbe Einsparung beim gesamten Stromverbrauch. Bei technischen Berichten lohnt deshalb die Frage: Was genau wurde gegenüber welcher Vergleichsarchitektur reduziert?
Beim Training werden die Gewichte angepasst. Auf das grundlegende Vortraining können weitere Phasen folgen, etwa Lernen aus Beispielen oder Rückmeldungen. Nachtraining soll unter anderem erreichen, dass das Modell Anweisungen befolgt und brauchbare Antworten liefert.
InferenzDer laufende Betrieb eines fertig trainierten Modells – das Erzeugen von Antworten auf Anfragen. Anders als das einmalige Training fällt Inferenz bei jeder Nutzung an.Mehr im Wissen → ist die Nutzung der vorhandenen Gewichte. Ein Chat kann neues Wissen im Gesprächskontext berücksichtigen, ohne die Gewichte zu ändern. Dauerhafte Notizen einer App und eine spätere Verwendung von Chats für Anbietertraining sind davon getrennte Vorgänge.
MerksatzIm Gespräch kommt Information hinzu. Das ist noch kein Nachtraining des Modells.